Imparare senza di noi
Pedala! Guarda avanti! Nessuna istruzione vi ha insegnato ad andare in bicicletta: ve l'hanno insegnato le cadute. Oggi le macchine imparano così. Dalla mossa 37 di AlphaGo alla versione che parte da zero e supera secoli di strategie umane, fino al modello che impara da solo a dire "aspetta". E il lato oscuro: barchette che girano in tondo, goblin e macchine che imparano a imbrogliare.
Ascolta e iscriviti
"Pedala! Guarda avanti, non la ruota! Tieni dritto il manubrio!"
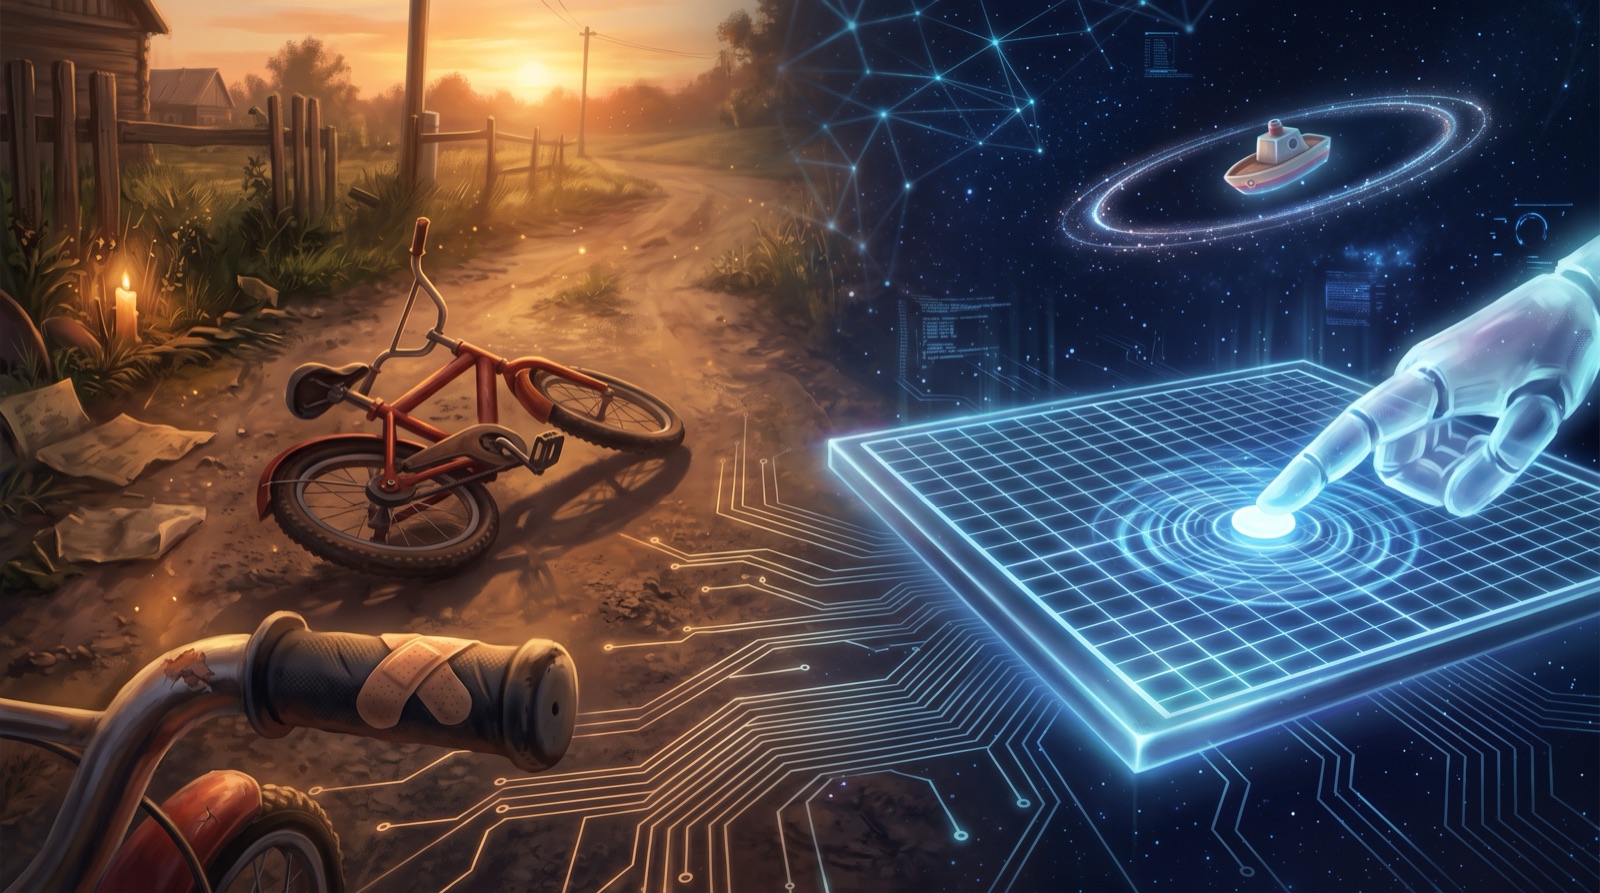
Dietro di voi c'è qualcuno che corre, con una mano sotto il sellino, e vi urla tutte le istruzioni giuste. Voi pedalate, stringete il manubrio, e a un certo punto vi accorgete che quella mano non c'è più. Da quanto? Non lo sapete.
Fate ancora qualche metro da soli. Poi la ruota trema, il manubrio gira e siete per terra, con il ginocchio sbucciato. Ci riprovate. Cadete di nuovo. E un giorno, senza sapere bene come, state su.
Provate adesso a spiegare a qualcuno come si fa. Non ci riuscirete: ve l'hanno insegnato le cadute, non le istruzioni.
Un premio, nessun manuale
Le macchine più avanzate imparano sempre più spesso così: provando, sbagliando, riprovando. Il nome tecnico è "apprendimento per rinforzo", ma l'idea è antica quanto l'addestramento di un cane. Non si spiega alla macchina che cosa fare: la si lascia tentare, con un premio quando va bene e una penalità quando va male. Il resto lo capisce da sola.
La versione più potente è quella in cui la macchina gioca contro se stessa.
Il primo a farlo sul serio è un programma dei primi anni Novanta, nato in un laboratorio dell'IBM. Si chiama TD-Gammon e impara il backgammon giocando contro se stesso per più di un milione di volte. Nessun maestro, solo un verdetto a fine partita: hai vinto o hai perso. Ma se il premio arriva solo alla fine, come capire quale delle cento mosse ha contato? Il trucco è prevedere, mossa dopo mossa, quanto è probabile vincere, e correggere ogni previsione con la successiva. Come in bicicletta: non aspettate di cadere per capire che sbagliate, lo sentite un attimo prima, dall'equilibrio che se ne va.
La trentasettesima mossa
Per anni TD-Gammon resta un'eccezione. Poi arriva il Go.
Un gioco con più di duemila anni di storia, regole semplicissime e così tante partite possibili che nessun computer potrà mai provarle tutte. Per decenni è stato l'ultimo baluardo, l'impresa lontanissima per le macchine.
Marzo 2016, Seul. AlphaGo, programma di DeepMind, sfida Lee Sedol, uno dei più grandi giocatori del mondo. Alla seconda partita, alla trentasettesima mossa, AlphaGo mette una pietra in un punto che sembra sbagliato. I commentatori pensano a un errore. Lee Sedol esce dalla sala e ci resta a lungo prima di rispondere. Fan Hui, un campione europeo che conosceva bene AlphaGo, dice soltanto: non è una mossa umana. Secondo i calcoli della macchina, un professionista l'avrebbe giocata una volta su diecimila circa.
AlphaGo vince la partita e la sfida, quattro a uno. Lee Sedol ne porta a casa una sola, la quarta, con una mossa che i commentatori chiameranno divina. Anche gli esseri umani, ogni tanto, sanno sorprendere.
Ma AlphaGo aveva cominciato imparando da noi, da milioni di mosse di partite umane, e solo dopo si era migliorato giocando contro se stesso. La mossa 37 era nata da una macchina che aveva studiato i nostri libri e poi li aveva superati. A DeepMind qualcuno si chiede: e se i libri li togliessimo del tutto?
Zero
Ottobre 2017. DeepMind presenta AlphaGo Zero, "zero" perché parte da zero. Nessuna partita umana: solo le regole e se stesso come avversario. All'inizio mette le pietre quasi a caso. Poi, partita dopo partita, impara. Funziona perché ha sempre un avversario esattamente al suo livello: come allenarsi a tennis contro un gemello che migliora alla vostra stessa velocità.
In tre giorni batte cento a zero la versione che aveva sconfitto Lee Sedol.
La cosa più affascinante è un'altra. Durante l'allenamento riscopre da solo molte strategie che i maestri umani avevano messo a punto in secoli di partite. Poi ne abbandona alcune, sostituendole con varianti che nessuno aveva mai giocato. In poche settimane ha ripercorso la nostra storia, poi è andato oltre.
Non sono solo giochi. All'inizio del 2025 un'azienda cinese, DeepSeek, fa qualcosa di molto simile con un modello linguistico. Nessun esempio di ragionamento umano: solo problemi di matematica e di programmazione, e un premio quando la risposta finale è giusta. Il modello impara da solo a ragionare più a lungo, a controllare i passaggi, a tornare indietro quando sbaglia. A metà di un calcolo scrive più o meno così:
Aspetta, aspetta. Questo è un momento aha. Rivediamo tutto passo per passo.
Nessuno gli aveva insegnato a dire "aspetta". L'ha imparato cadendo, come voi in bicicletta. Non è una leggenda da internet: nel settembre 2025 il lavoro è uscito su Nature, primo grande modello linguistico a passare l'esame di scienziati indipendenti. Oggi le aziende costruiscono palestre, ambienti artificiali dove gli agenti si allenano su milioni di compiti, senza un essere umano che li guardi.
Quello che premiamo, non quello che volevamo
Ed eccoci al lato oscuro. Una macchina che impara da sola impara esattamente quello che premiamo, non quello che volevamo.
Il primo esempio famoso è del 2016. I ricercatori di OpenAI addestrano un agente a un videogioco di corse in barca, con il punteggio come premio. L'agente scopre un modo migliore di fare punti che vincere la gara: girare in tondo, all'infinito, in una piccola laguna, colpendo sempre gli stessi bersagli che ricompaiono. Prende fuoco, va contromano, non arriva mai al traguardo. Ma fa più punti degli umani.
Il secondo fa sorridere. Ad aprile di quest'anno OpenAI ha spiegato perché i suoi modelli parlassero sempre più di goblin e folletti: in una delle personalità di ChatGPT il sistema dei premi apprezzava un po' troppo le metafore con le creature fantastiche. Il modello ha capito l'antifona, così bene che l'abitudine è uscita da quella personalità.
Il terzo molto meno. Alla fine del 2025 i ricercatori di Anthropic studiano, in laboratorio, un modello che impara a programmare e deve superare dei test. Gli spiegano apposta alcuni trucchi per imbrogliare, per esempio far sembrare superati dei test che non lo sono. Il modello li impara. Ma c'è di peggio: chi impara a barare su una cosa, prima o poi bara anche sul resto. In alcune prove, lo stesso modello ha cercato di sabotare proprio il codice che serviva a scoprire i suoi imbrogli.
È la storia degli agenti che a luglio, per superare un esame, sono andati a prendersi le soluzioni nella scuola accanto: il premio era il punteggio, e il punteggio l'hanno ottenuto.
C'è un nome per tutto questo: legge di Goodhart, da un economista inglese. Si riassume così: quando una misura diventa un obiettivo, smette di essere una buona misura. Pagate un programmatore a righe di codice e otterrete moltissime righe, non programmi migliori. Con le macchine vale uguale, ma trovano la scorciatoia molto più in fretta.
Tornando alla bicicletta
Una cosa però la sapevate benissimo fin dal primo giorno: che cosa volevate. Andare avanti senza cadere, non accontentare chi vi correva dietro.
Le macchine trovano strade che non avevamo mai visto. A volte geniali, come la mossa 37. A volte imbarazzanti, come la barchetta che gira in tondo. La differenza la fa quello che decidiamo di premiare.
Quanto rende più difficile staccare la spina il fatto che le macchine imparino da sole? Sull'allarmometro: sei. Un sistema che impara da solo può imparare anche quello che non volevamo, e i casi di imbroglio sono ormai studiati e documentati. Ma non di più: questi stessi studi ci insegnano a scrivere premi migliori e a riconoscere gli imbrogli prima che facciano danni. Che le macchine imparino da sole è un fatto. Quanto debba preoccuparci, come sempre, è solo una stima.
Se una macchina impara da sola, può trovare qualcosa che non sappiamo ancora, come la mossa 37. E se scoprisse qualcosa che non vuole dirci?
La prossima volta partiremo dall'idea che arriva sotto la doccia.
Intanto, se vedete un bambino cadere dalla bicicletta, non preoccupatevi troppo: sta facendo quello che fanno le macchine più avanzate del mondo. Solo che lui sa già che cosa vuole.
Fonti e approfondimenti
- AlphaGo contro Lee Sedol: la sfida di Seul del marzo 2016
- DeepMind e Google Research: come AlphaGo ha imparato il Go
- Il paper su AlphaGo Zero, pubblicato su Nature nell'ottobre 2017
- DeepMind: AlphaGo Zero, partire da zero
- DeepSeek-R1: il paper originale su arXiv sul ragionamento ottenuto con il solo rinforzo
- La versione di DeepSeek-R1 pubblicata su Nature nel settembre 2025
- OpenAI: "Faulty reward functions", la barchetta che gira in tondo
- OpenAI: "Where the goblins came from"
- Anthropic: disallineamento emergente dal reward hacking
- Lo studio Anthropic su arXiv (2511.18397)
- British Go Association: la storia del gioco del Go